Хто працював у Windows, у того фраза «розпізнавання тексту» одразу асоціюється з ABBYY FineReader. Програма хороша, але платна, і недешева. А що з цим у Linux? Тут усе безкоштовно, і для більшості задач цього цілком досить: відсканований документ, фото сторінки, скриншот із текстом, який не можна виділити, – усе це перетворюється на звичайний текст за кілька кліків.
Нижче розповім про програми, якими користуюся сам: gImageReader для документів, Frog і NormCap для швидкого розпізнавання з екрана, а також про консольні інструменти для тих, кому треба обробити багато файлів одразу.
Tesseract – серце розпізнавання в Linux
Майже всі програми для розпізнавання тексту в Linux під капотом використовують Tesseract – безкоштовний рушій із відкритим кодом, який розуміє понад сотню мов, зокрема українську. Колись поруч із ним згадували ще CuneiForm, але його давно ніхто не розвиває, тож сьогодні вибір очевидний.
Сам Tesseract працює в терміналі, а програми нижче дають йому зручний інтерфейс. Головне – не забути поставити мовний пакет для української, інакше кирилицю програма розпізнаватиме як набір випадкових символів.
gImageReader – для сканів і документів
Це моя основна програма для розпізнавання. Відкриваєш зображення або PDF, виділяєш потрібну ділянку (або всю сторінку), обираєш мову – і за кілька секунд отримуєш текст, який можна відредагувати, перевірити на помилки й зберегти у файл.
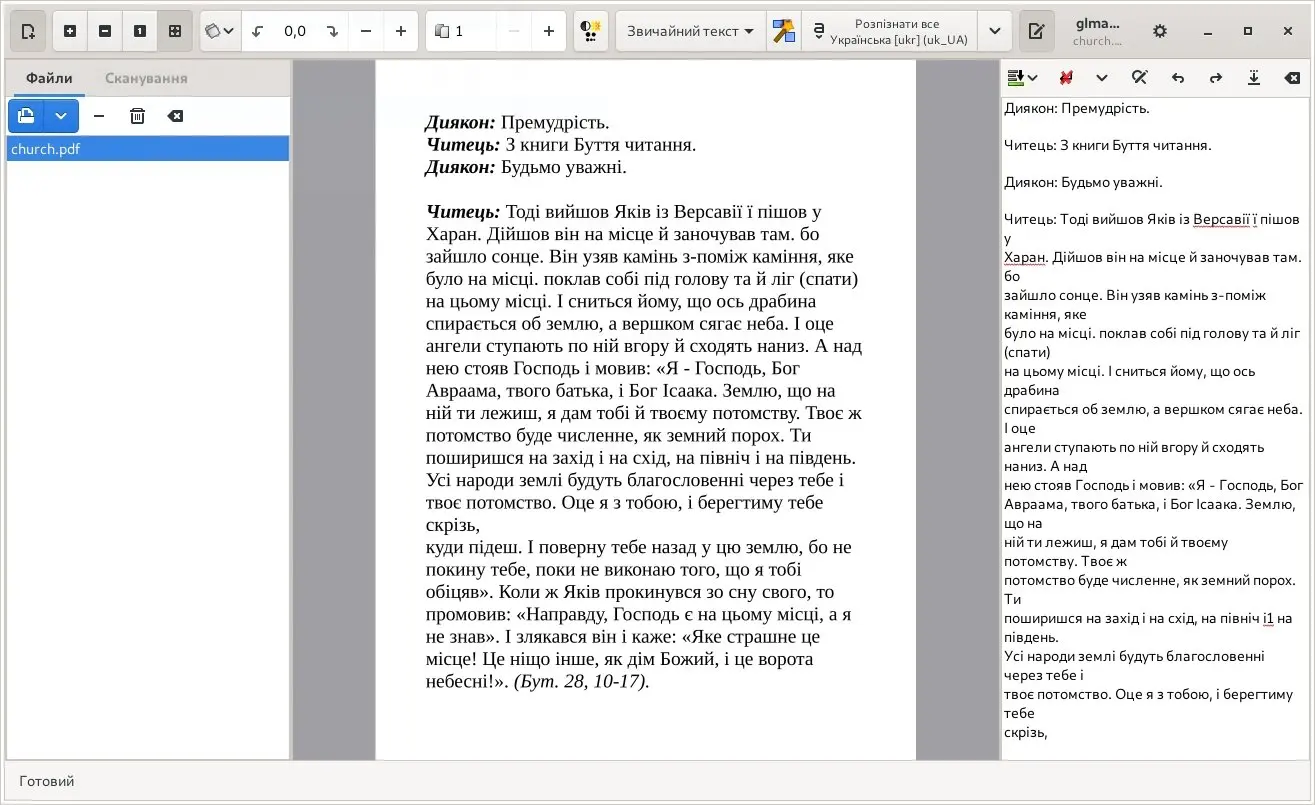
Встановлення в Ubuntu та Linux Mint:
sudo apt install gimagereader tesseract-ocr-ukr hunspell-ukВ Arch Linux та Manjaro:
sudo pacman -S gimagereader-gtk tesseract-data-ukr
yay -S hunspell-uk
Пакет hunspell-uk – це український словник для перевірки орфографії: з ним gImageReader підкреслює слова, які розпізнав із помилками. В Arch він лежить в AUR, тому ставимо його через yay. Якщо тобі ближчий інтерфейс у стилі KDE, замість gimagereader-gtk можна поставити gimagereader-qt. Також gImageReader є у Flathub.
Кілька порад із власного досвіду:
- Якщо в тексті трапляються англійські слова, познач у списку мов і українську, і англійську.
- Якість розпізнавання сильно залежить від картинки: рівна, чітка сторінка з хорошим контрастом розпізнається майже без помилок. Скан краще робити з роздільною здатністю 300 dpi.
- Криве фото сторінки варто спершу вирівняти й підтягнути контраст – у самому gImageReader або в ImageMagick.
Frog і NormCap – текст з екрана за секунду
Буває, що текст треба взяти не з документа, а просто з екрана: з відео, картинки в месенджері, вікна програми, де текст не виділяється. Для цього є дві маленькі зручні програми.
Frog – запускаєш, виділяєш ділянку екрана, і розпізнаний текст одразу з'являється у вікні програми, готовий до копіювання. Також можна просто перетягнути у вікно картинку чи вставити її з буфера обміну. Мовні пакети, зокрема український, Frog пропонує завантажити прямо зі своїх налаштувань.
NormCap працює ще простіше: виділяєш ділянку – і текст уже в буфері обміну, без жодних вікон. Її зручно повісити на гарячу клавішу так само, як я описував для Flameshot у KDE Plasma.
Обидві програми найпростіше встановити з Flathub:
flatpak install flathub com.github.tenderowl.frog
flatpak install flathub com.github.dynobo.normcap
Розпізнавання в терміналі
Якщо файлів багато, швидше обійтися без інтерфейсу. Розпізнати картинку в текстовий файл:
tesseract scan.png result -l ukr+engПоруч з'явиться файл result.txt. А якщо в кінці команди дописати pdf, Tesseract створить PDF, у якому текст можна шукати й копіювати:
tesseract scan.png result -l ukr+eng pdfДля готових PDF-файлів (наприклад, відсканованої книжки) зручніша утиліта OCRmyPDF. Вона додає в документ невидимий текстовий шар, а сам документ залишається таким самим:
ocrmypdf -l ukr+eng book.pdf book-ocr.pdfВ Ubuntu та Linux Mint вона ставиться командою sudo apt install ocrmypdf, а в Arch – з AUR.
Яку програму обрати
- Скани, PDF і багатосторінкові документи – gImageReader.
- Швидко вихопити текст з екрана – NormCap (одразу в буфер) або Frog (з переглядом результату).
- Багато файлів або PDF із текстовим шаром – tesseract і OCRmyPDF у терміналі.
І все це повністю безкоштовно 😉 Інші програми для роботи з картинками зібрані за позначкою Обробка зображень, а про знімки екрана читай у статті про найкращу програму для скріншотів у Linux.
А чим розпізнаєш текст ти? Пиши в коментарях 🙂

леле, я востаннє цікавився (трішечки) темою років зо п’ять тому… обидва пакети вже існували, але толку від них не дуже було. треба знову спробувать (хоча, направду, зараз немає потреби щось розпізнавати, але хто зна, може знадобитися колись). подякував за допис!